1.利用 workbuddy 去操控 comfyui 能够提升对提示词更加智能的优化策略
我这里使用的是 Claude fable 模型,用的是本地搭建的 comfyui ,基于之前我曾分享过的 Nano Banana Pro 和不断迭代的 Chatgpt 2.6 的 comfyui 插件。我为什么还推荐用 comfyui 是因为,可以自定义撰写插件来调用其他模型的 apikey,它不需要你另外去搭建一个框架来做这个事。它已经具备无限画布的成熟框架,并且各个节点都是可视化的。你可以随时回到 comfyui 查看,搭建的工作流程,特别适合个人开发者使用。
为什么能提供更加智能的优化策略是因为 workbuddy 利用大模型调用,可以更加灵活,大模型能给你更好的解决方案,你只需要和它聊天。帮你撰写提示词,甚至给出更好的提示词方案,毕竟它最懂模型。
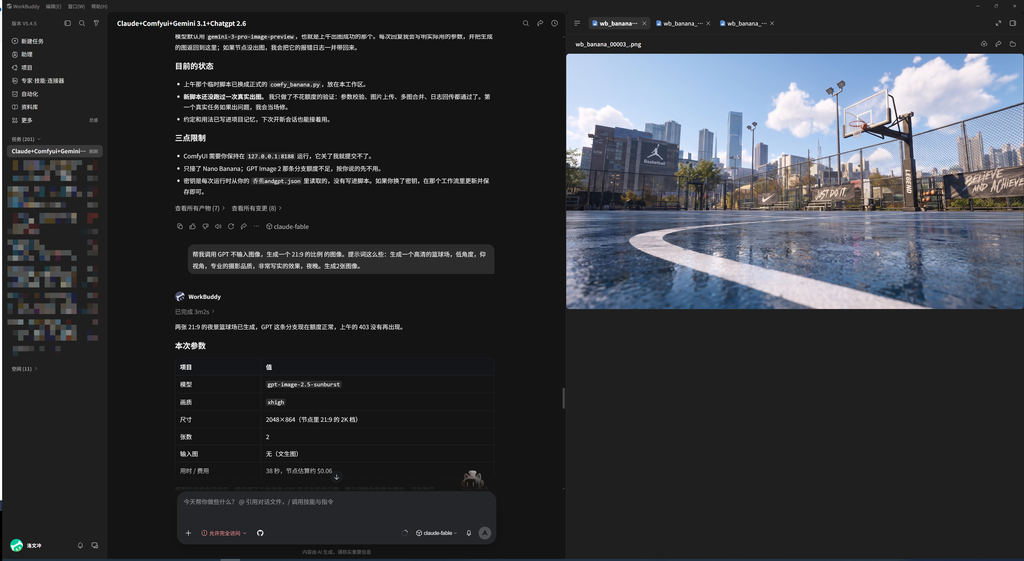
2.生成结果 可以利用大模型提供更加最优解的提示词调整方向
我在写这篇文章,做了一个图像的生成案例。我要求 ChatGPT image 生成一个夜晚的篮球场,要求实拍品质效果。
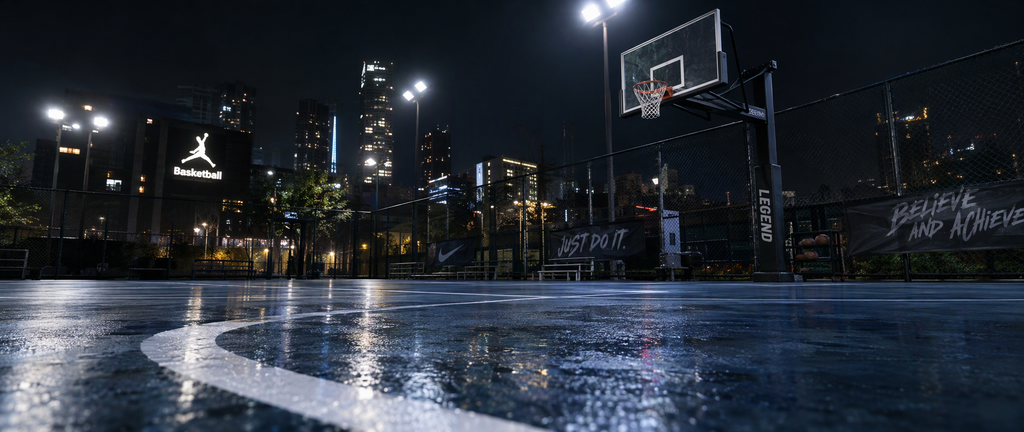
然后,我交给 nano banana 进行高清处理,并且生成白天的场景,保持视角不变。
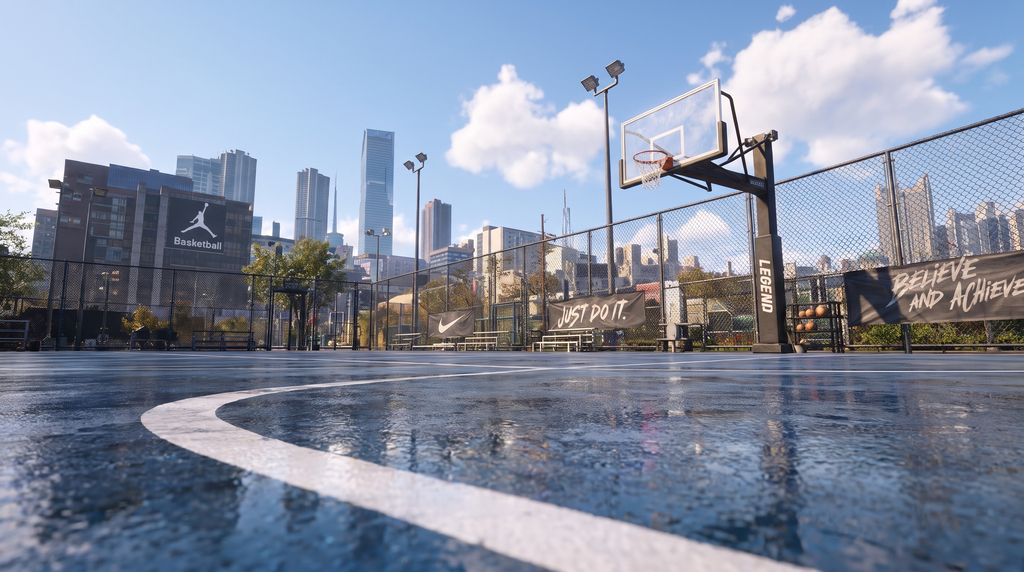
workbuddy在获得 comfyui 生成的结果后给出的回应:
三点留意
质感比底图偏 CG。 夜景那张像实拍,这张更像游戏引擎渲染,建筑和云的边缘偏干净。
地面仍是湿的。 雨后积水和反光原样保留,在晴天下略显不合理。要干燥地面需要在提示词里写明。
品牌标识还在。 Jordan 标志、Nike 勾和 “JUST DO IT” 都保留了,商用前要去掉。
但是发现地面并非是干燥的,并且专业的篮球场的白线并不是这样的。但是大模型会提供更好的建议。
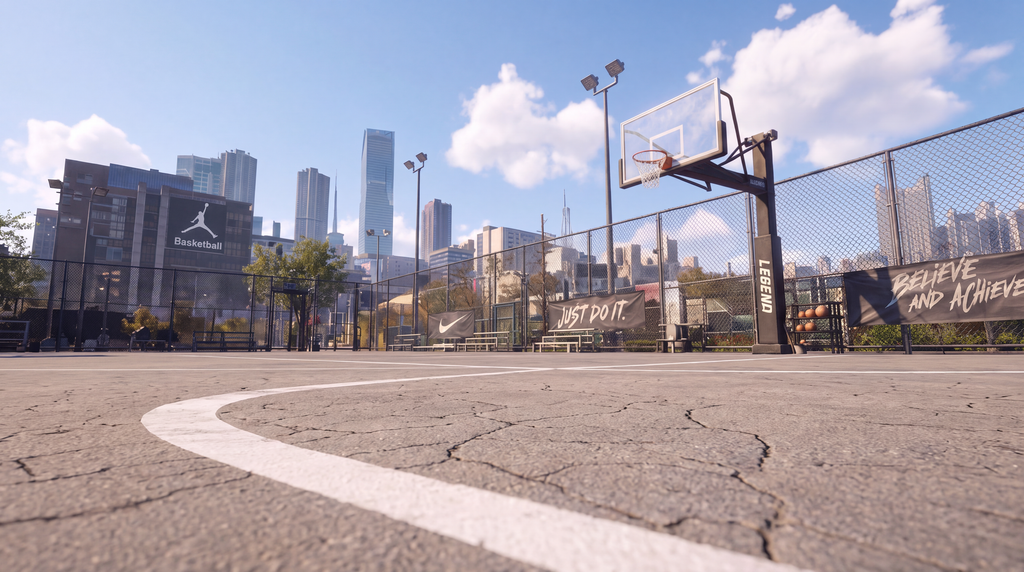
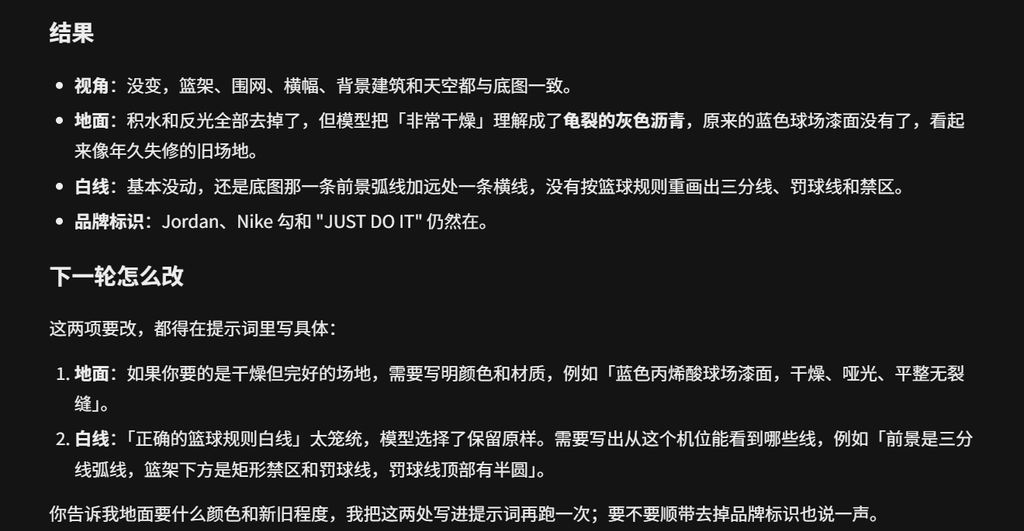
最终我按照他给的要求,生成了我想要的效果。
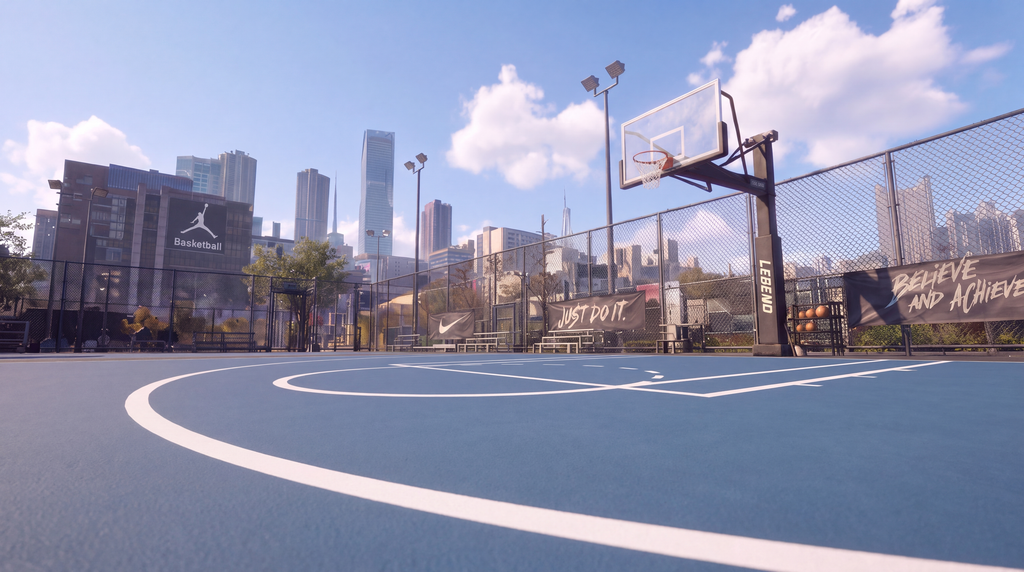
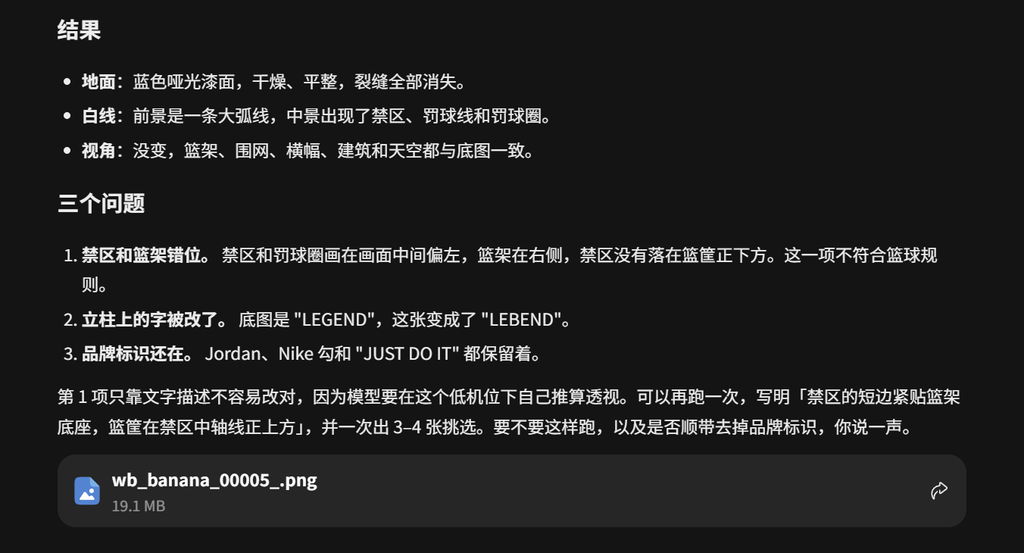
结合图像效果以及 workbuddy 给出的建议反馈,显然他比我更懂这个图应该如何修改的更加专业化。
3.可更加自动化、批量化的自定义你的图像生成需求
如果你使用 comfyui 下生成图像流程,往往无法提交自定义的文件,例如:表格、文档
而在 workbuddy 与 comfyui 连接下,你提交的内容可以更加多样,甚至提交的视频可以利用让大模型帮你抽帧,再交给 comfyui 下的插件模型进行生成。操作非常顺滑自然。
插件下载地址:
Comfyui-Chatgpt image 2.6(目前已经支持到2.6):https://github.com/yitao2020/ComfyUI-GPT-Image-2
Comfyui-Gemini image 目前已经支持到 Nano banana 2.1 版本:https://github.com/yitao2020/comfyui_Nano_banana_pro_apiyi